Busca em largura
O enunciado exige que o arquivo de saída traga o caminho mais curto da entrada até a saída,
escrito com uma letra por passo (N para cima, E para a direita, S para baixo, W para a
esquerda), e que o desenho na tela possa mostrar esse caminho. No modo Pac-Man há vários caminhos
possíveis, e o programa precisa achar o de menos passos. Esta página mostra o algoritmo que faz
isso, a busca em largura, que a classe Solver implementa.
O Solver é chamado uma vez por labirinto, pelo MazeGenerator (a classe que coordena a
geração, parte 9). O resultado vai para a última linha do arquivo
de saída e para o desenho do caminho na tela.
A ideia: água espalhando pelos corredores
Imagine despejar água na célula de entrada. A cada segundo, a água avança uma célula por todos os corredores ao mesmo tempo, passando só onde há passagem (lado aberto). Anote em cada célula o segundo em que a água chegou nela; esse número é a distância da célula até a entrada, em passos:
- a entrada está a distância 0;
- as células ligadas a ela por uma passagem estão a distância 1;
- as células ligadas às de distância 1, e ainda secas, estão a distância 2;
- e assim por diante, até a água chegar a todas as células alcançáveis.
Cada grupo de células com a mesma distância é uma camada. Explorar camada por camada, das mais próximas para as mais distantes, é o que se chama busca em largura (em inglês, breadth-first search, ou BFS): ela se espalha para os lados antes de ir longe.
Na figura abaixo, um tabuleiro Pac-Man de 9 colunas por 7 linhas (gerado com a semente 4): o
número em cada célula é a distância até a entrada 0,0; quanto mais escuro o azul, mais longe.
As células cinza são o "42", onde a água nunca entra:
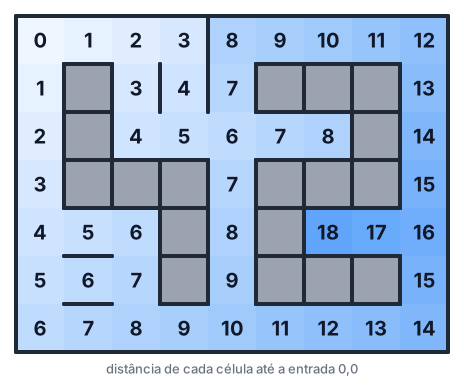
A saída, no canto de baixo à direita (8,6), está a 14 passos. Saindo da saída e indo sempre para
uma vizinha ligada por passagem com o número uma unidade menor (14, 13, 12...) até chegar ao 0,
desenha-se um caminho mais curto:
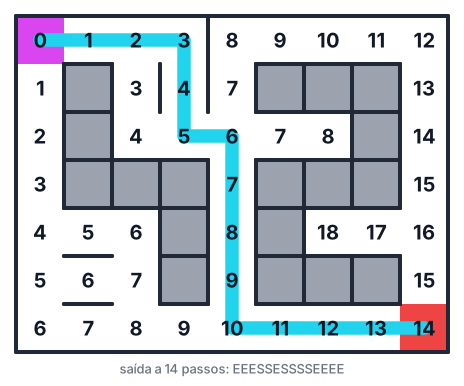
Na segunda figura, a célula magenta é a entrada, a vermelha é a saída e a faixa ciano é o caminho.
A fila
Para examinar as células em ordem de distância, a busca usa uma fila, como a de um banco: quem chega entra no fim, e quem é atendido sai da frente. O primeiro que entra é o primeiro que sai.
Cada célula passa por dois momentos, e os dois têm nome:
- descoberta: a busca encontrou a célula, anotou a distância dela e a pôs na fila. Uma célula é descoberta uma única vez e nunca volta para a fila;
- tratada: a célula saiu da frente da fila e teve as vizinhas examinadas.
O algoritmo:
- põe a entrada na fila, com distância 0: ela é a primeira célula descoberta;
- tira a célula da frente da fila e passa a tratá-la;
- se essa célula é a saída, para: a distância dela já está anotada;
- para cada vizinha dela, ligada por uma passagem e ainda não descoberta, anota a distância (a da célula tirada mais 1) e a põe no fim da fila;
- volta ao passo 2 enquanto houver células na fila.
A distância aparece nesta página e nas figuras só para mostrar a ordem em que as células são
descobertas. O código do Solver não guarda distância nenhuma: no passo 4, ele anota de qual
célula a vizinha foi descoberta, que é o que serve para escrever o caminho em letras
(página 2). A ordem de descoberta é a mesma.
Numa grade 3x2 sem nenhuma parede por dentro, da entrada 0,0 até a saída 2,1. O número é a
distância; laranja é a célula que acabou de sair da frente, azul são as células
descobertas que ainda esperam na fila, verde as já tratadas e branco as ainda não
descobertas. As linhas tracejadas são as passagens (lados abertos). Embaixo de cada quadro, a
fila, da frente para o fim:
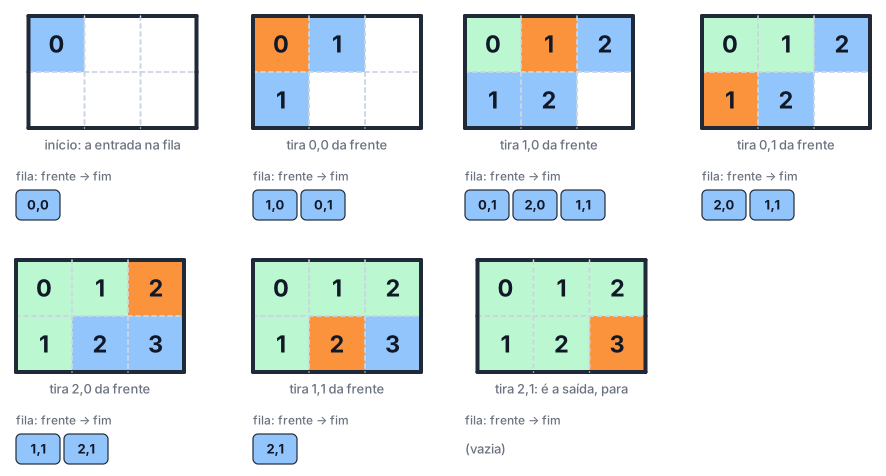
No último quadro, a saída 2,1 sai da frente da fila, e a busca para (passo 3).
Repare que as células de distância 1 entram na fila antes de qualquer uma de distância 2, e as de
distância 2 antes de qualquer uma de distância 3. Isso acontece sempre: uma célula de distância
d + 1 só é descoberta quando sai da fila uma de distância d, e todas as de distância d já
estavam na fila antes dela. Da frente para o fim, a fila tem distâncias que só crescem.
Por que o primeiro caminho encontrado é o mais curto
Toda passagem vale 1 passo. A busca descobre primeiro todas as células a 1 passo, depois todas a 2 passos, e assim por diante. Se existisse um caminho mais curto até uma célula, ela teria sido descoberta numa camada anterior. Por isso, a distância anotada na primeira vez que uma célula é descoberta é a menor possível, e isso vale também para a saída.
Por que não outro algoritmo
A escolha da busca em largura é do projeto; o enunciado só exige o caminho mais curto.
| Alternativa | O que é | Por que não |
|---|---|---|
busca em profundidade (a do Carver, parte 6) | vai fundo num caminho antes de tentar outro | encontra um caminho, não necessariamente o mais curto. No modo perfeito o caminho é único e daria certo, mas no Pac-Man há ciclos e ela pode dar a volta longa |
| Dijkstra | busca para caminhos em que cada passo pode custar diferente | aqui todo passo custa 1, e com custo igual o Dijkstra faz exatamente o que a busca em largura faz, com uma estrutura a mais: a fila de prioridade, uma fila que sempre entrega primeiro o item de menor custo, em vez do que chegou antes |
| A* (lê-se "A estrela") | busca que usa uma estimativa da distância que falta para ir primeiro na direção da saída | é mais rápida em mapas enormes; 100x100 são 10 000 células, e a busca em largura já as percorre num instante |
deque em vez de list
Em Python, a fila é um collections.deque (lê-se "deck", de double-ended queue, fila com duas
pontas):
| Operação | Com deque | Com list |
|---|---|---|
| pôr no fim | fila.append(x) | fila.append(x) |
| tirar da frente | fila.popleft(): custo sempre igual | fila.pop(0): desloca todos os outros itens uma posição para a esquerda |
Com uma list, cada retirada da frente fica mais cara quanto maior a fila. O deque foi feito
para tirar e pôr nas duas pontas com o mesmo custo, por isso é a fila padrão do Python.